Na LinkedIn ani sociálních sítích nemám bůhvíjaký dosah. Pokud čtete tenhle text, je tak dost pravděpodobné, že už jsme se spolu o vývoji s AI nástroji a o tom, jak k němu v grid.online přistupujeme, někdy v minulosti bavili. Takže už jsem vám vysvětloval, že AI ve vývoji bereme relativně konzervativně a opatrně. Abych si tenhle přístup dokázal posunout — nebo aspoň zvalidovat — potřeboval jsem si zkusit i ten opačný. Vzít Clauda a navibecodit si appku, aniž bych se jedinkrát podíval na vygenerovaný kód.
Vznikla Trekle
Appka, která je výsledkem mého vibecodingu, se jmenuje Trekle. Je aktuálně dostupná na obou storech, v Google Play i App Storu, její součástí je i backendová vrstva. Vznikala ve volných chvílích cca měsíc, dohromady nějakých 50 hodin.
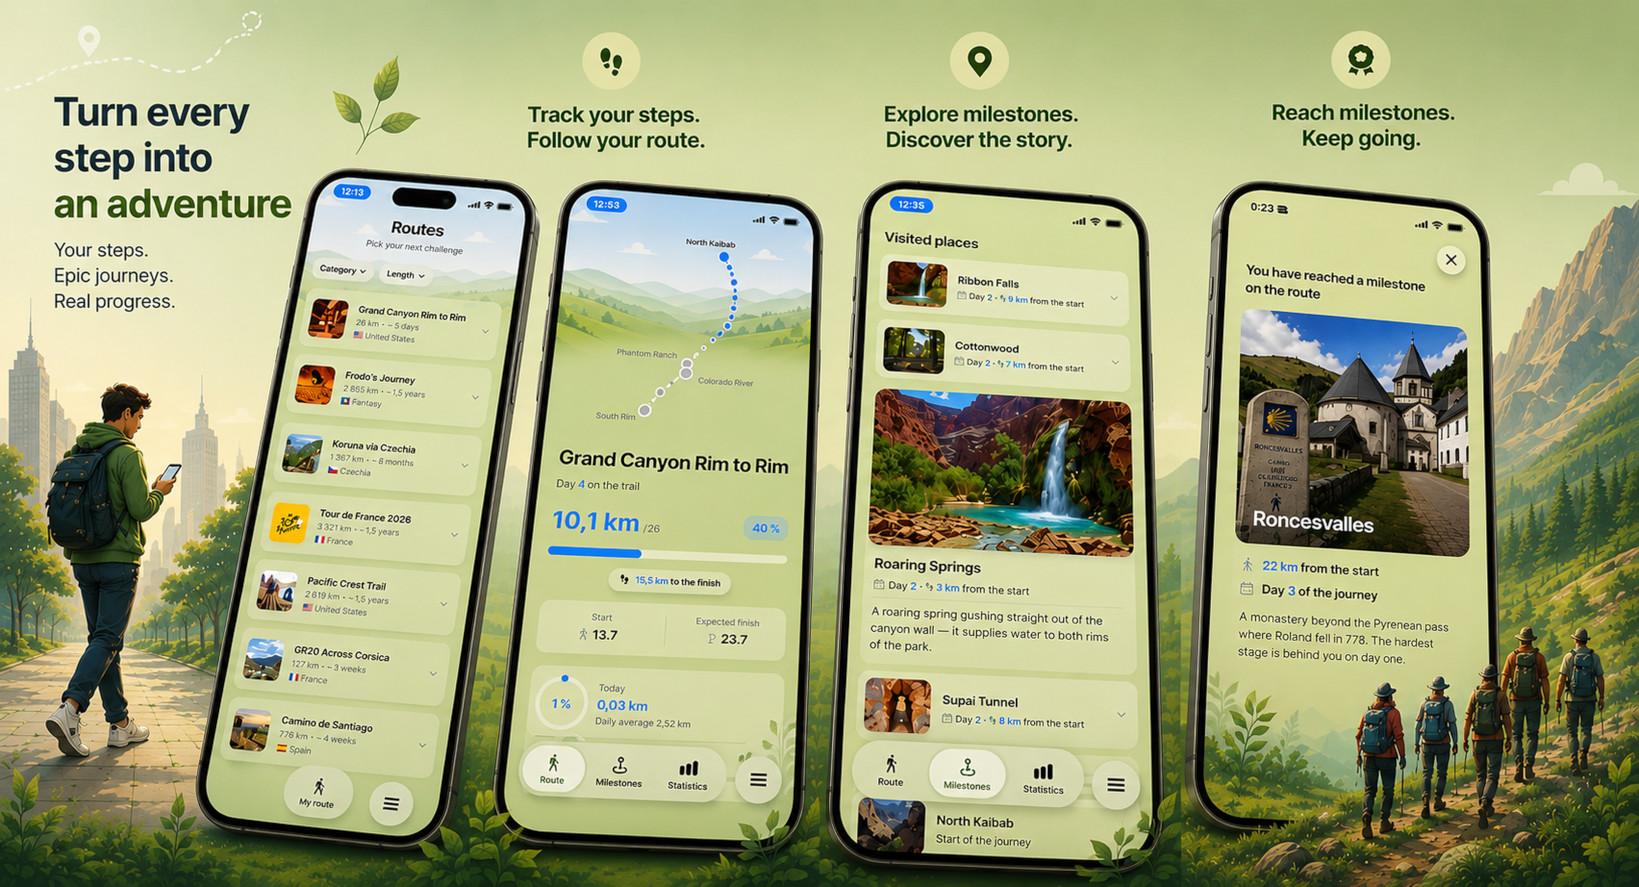
Je vlastně strašně jednoduchá. Jde o gamifikaci každodenního chození: z Apple Health / Google Health Connect si čte počet nachozených kroků nebo vzdálenost a tu promítá do reálných populárních treků — Pacific Crest Trail, korsická GR20 a další, nebo do fantasy putování, jako např. Frodova cesta z Pána prstenů. Chodíte po městě a nachozenou vzdálenost vám appka zobrazuje na těchhle trasách. A když se propojíte s kamarády a jdete stejnou trasu, můžete se navzájem porovnávat.
V čem se to lišilo od práce v gridu
Zásadní rozdíl mezi tím, jak pracujeme s AI v gridu, a tímhle vibecodingem je vlastně jenom jeden — ale důležitý. Při vývoji jsem vůbec nekontroloval kód, který AI napsala. Jinými slovy akceptoval jsem první Claudův návrh. Naproti tomu při vývoji v gridu trváme na tom, že kód garantuje vývojář. Ten tak výsledek validuje a commituje často až po několika iteracích a opravách. Tady jsem případné úpravy dělal až na základě výsledků testování nebo následného provozu.
Důležité ale je, že zadání jsem pořád dával vývojářsky. Ne byznys zadání — neříkal jsem, jak má vypadat appka, nedával jsem mu popis produktu. Vysloveně jsem Clauda krok po kroku vedl: jak mají vypadat entity, jak přesně mají probíhat procesy a vyhodnocování jednotlivých situací a tak dál. A říkám rovnou: tohle byl hrozně důležitý aspekt, který mi po celou dobu vývoje dával dostatečnou confidence, že mám vývoj pod kontrolou a že na konci vznikne to, co chci.
Dá se říct, že díky tomu (nebo kvůli tomu) jsem se nedostal do totálního vibecodingu. Takže ani po tomhle experimentu nedokážu říct, jak úspěšně dokážou vibecodit PMs nebo CEOs. To ale ani nebyl můj cíl — já jsem potřeboval zjistit, jak daleko můžu AI ve vývoji pustit já sám, kolik autonomie mu můžu bezpečně dát..
Jak to dopadlo
Long story short: appka dopadla dobře. Je dostupná na obou storech a funguje. Kód backendové části, když jsem si ho na konci přeci jen prošel, vypadá fajn — nemám k němu žádné zásadní výhrady. Kód jednotlivých mobilních appek jsem neviděl. A popravdě, i kdybych ho viděl, asi ho úplně nevyhodnotím.
Zásadní ale je, že všechny tři části projektu jsou super jednoduché. Když jsem na začátku appku popisoval, byl ten popis kompletní — celá appka je tedy popsatelná ve třech větách. To se se systémem, jako je grid, samozřejmě nedá srovnávat. Přesto si myslím, že se z toho pokusu nějaké pozitivní závěry vzít dají.
Jedna potvrzená obava
I v tomhle malém projektu claudovi utekla jedna klíčová race condition. Je fér bavit se o tom, jestli by na stejném místě tuhle race condition odhalil člověk. Myslím, že zkušený vývojář ano, ale s jistotou to říct nemůžu. Každopádně opatrnost při hlídání těchhle problémů je evidentně na místě. Nemyslím si, že je to sám o sobě blocker pro větší spoléhání se na AI při vývoji — jenom je potřeba o tomhle problému vědět, přizpůsobit mu testování a počítat s ním.
Další důvody proč nedat AI větší volnost
Existuje několik nejčastějších typů nálezů, kvůli kterým kód s AI často několikrát iterujeme a každý commit stále kontrolujeme. A o všech typech ale platí, že Trekle je moc jednoduchá na to, aby potvrdila, že je to skutečně potřeba, nebo ukázala opak.
1. Funkčnost a efektivita. Čas od času narážíme na to, že vygenerovaný kód nedělá úplně přesně to, co chceme, nebo to nedělá dostatečně efektivně, nebo volá jiný existující kus kódu tak často, že způsobí performance issues. Na tohle můj vývoj nenarazil — a je to asi celkem logické. Jednak kvůli jednoduchosti appky, jednak proto, že jsem ji vyvíjel od nuly a celá je zatím monolitem. Když si tady pomůžu zkušenostmi z gridu, dá se vysledovat celkem spolehlivé pravidlo: důležitým triggerem pro chybovost a kvalitu architektonických rozhodnutí je komplexita kódu do kterého nový kód zasazujeme. Při psaní kódu tzv. na zelené louce na zásadní architektonické chyby nenarážíme. Jakmile ale upravuje existující netriviální kód, čas od času se rozhodne špatně. Použije jako klíč atribut který není unikátní, data získává složitou cestou, atd. Čím oddělenější a samy o sobě jednodušší a ucelenější kusy kódu a moduly budeme vyvíjet — ať už servisy, nebo moduly v rámci servis — tím bezpečnější bude vibecoding přístup při vývoji.
2. Zpětná kompatibilita. Tohle je možná nejčastější důvod: Claude vygeneruje něco, co funguje krásně, ale není to možné nasadit do běžící produkce, protože chybí zpětná kompatibilita, nebo rollout-safe. Dost často Claude tenhle požadavek má v zadání i v obecných instrukcích a markdownech — a přesto čas od času nějakou zpětně nekompatibilní změnu udělá. Je možné, že se my naučíme líp zadávat, nebo modely dorostou do skillu, kdy tohle budou dělat líp. S mojí appkou jsem si ale nic takového neověřil — vyvíjel jsem na zelené louce a žádné problémy se zpětnou kompatibilitou jsem přirozeně neřešil. Možná se časem ukážou.
3. Udržitelnost kódu lidskými silami. Tady mi experiment taky nic nepotvrdil ani nevyvrátil, i na tohle je apka moc jednoduchá. Jestli by mě rezignace na schopnost číst kód v jednu chvíli vytrestala — tím, že si AI do kódu zanese takové špagety, že se jimi pak sama paralyzuje a bude dělat chyby pramenící z té složitosti — to pořád nevím. A zatím pořád nechci riskovat, že na tenhle problém narazíme v produkčním kódu.
Závěrem
Co mi tenhle experiment ukázal, je, že na specifickém kódu tenhle — ne jakýkoliv, ale tenhle uvědomělý — vibecoding může mít své místo i v profi vývoji. A jednoduchý kód se dá najít i v rámci složitého systému. Mimochodem v průběhu experimentu se vlastně původní otázka “můžeme i v gridu vibecodovat?” změnila na “kdy a do jaké míry můžeme slevit z důsledné kontroly kódu vygenerovaného AI?”.
Slevit můžeme, pokud vydefinujeme dostatečně izolovaný kus kódu s jasně popsaným kontraktem a pak ho specificky otestujeme a následně postavíme dostatečně silnou observabilitu. Po tomhle experimentu jsem si tím o něco jistější. Jenom se, stejně jako při přechodu od monolitu k microservices, složitost posouvá jinam: najednou jde o to správně definovat kontrakty těch jednotlivých izolovaných kusů. A i s tím dokáže AI, jen s jiným „mindsetem” a pohledem, výrazně pomoct.
Mimochodem, agentický přístup k vývoji tyhle závěry nijak nevyvrací, neruší. Z tohoto pohledu nepřináší revoluci. Všechny popsané problémy i kritéria platí i v něm. Agentický přístup jen posiluje robustnost AI generovaného vývoje, takže dovoluje ještě větší autonomii. Ale minimálně pro potřeby grid.online stále ne stoprocentní.
Při rozhodování, kdy pustit AI ve vývoji dál, než ji pouštíme dneska, jsou zásadní čtyři kritéria:
-
Izolovanost dané části - a tím pádem oddělitelnost jejího kontraktu. U featur a kusů kódu, které stojí samostatně, jsou dobře popsatelné, může uvědomělý vibecoding fungovat velmi dobře.
-
Ověřitelnost správnosti - jak spolehlivě mi testy dokážou potvrdit, že kód dělá přesně to, co má, a jak dobře dokážu případnou chybu následně odhalit v provozu. Tohle už není vůbec triviální otázka a vlastně je zásadní součástí samotného vývoje. Pro rozhodnutí o tom kolik autonomie AI dát je ale zásadní.
-
Komplexita kódu, do kterého zasahujeme. Nový modul, nová service, samostatný kus kódu jsou pro AI vývoj bezpečné. Jakmile ale upravuje existující netriviální kód, čas od času udělá špatné architektonické rozhodnutí. Čím složitější je stávající kód, tím důležitější je kontrola vývojářem.
-
Cena chyby - co mě bude stát případný bug ve featuře? Tady je potřeba postupovat opatrně. Neznamená to, že nekritický kód můžeme vibecodit hlava nehlava. I samotný bugfix a nutný tech-support má svou, ne úplně malou cenu. Myslím to spíš naopak — u kritického kódu je osobní zodpovědnost a kontrola vždy zásadní. Minimálně zatím.
Btw.
V čem byl Claude naopak skvělý, a to nejen při vývoji Trekle, ale především v grid.online, je škálování, ladění, databázová performance, atd. V tomhle směru nám už vyřešil nejeden bolehlav. A při mém vibecodingu byl skvělým průvodcem v obou app storech. Zkušeným mobilním vývojářům už to tak možná nepřijde, ale já bych bez AI možná přesně v tomhle místě celou hotovou apku zahodil a vývoj vzdal.
Trekle si můžete vyzkoušet sami: